서론

다른 회사도 다 그러는진 모르겠는데,, 이 회사에선 회사에서 진행하는 업무들을 '프로젝트' 로 구분하고, 프로젝트별로 매출/비용 등을 인지한다.
이를 위해선 하나의 법인 안에 합쳐져있는 예금, 카드, 세금계산서/계산서(이하 편의상 그냥 세금계산서.) 등에 대해 장부를 작성하면서 또한 각각 어떤 프로젝트에 속한지도 기록이 필요하다.

원랜 재무 직원이 진행을 했는데,, 회사가 커지고 프로젝트가 많아지니 감당이 안되어서, 각 부서별로 일단 세금계산서에 대해서만이라도 선처리를 해달라고 요청을 하게 되었다.

요청 내용은 대략 아래와 같다.
1. 세금계산서 목록을 홈택스에서 엑셀로 내려받는다
2. 엑셀에서 내 부서에 해당하는 항목들을 찾아 필터링 한다
3. 장부 작성용 계정과목도 분류한다. (eg, 가스수도비, 용역비, ...)
4. 회계 프로그램에 각 내용을 하나씩 입력한다. (전표 생성)
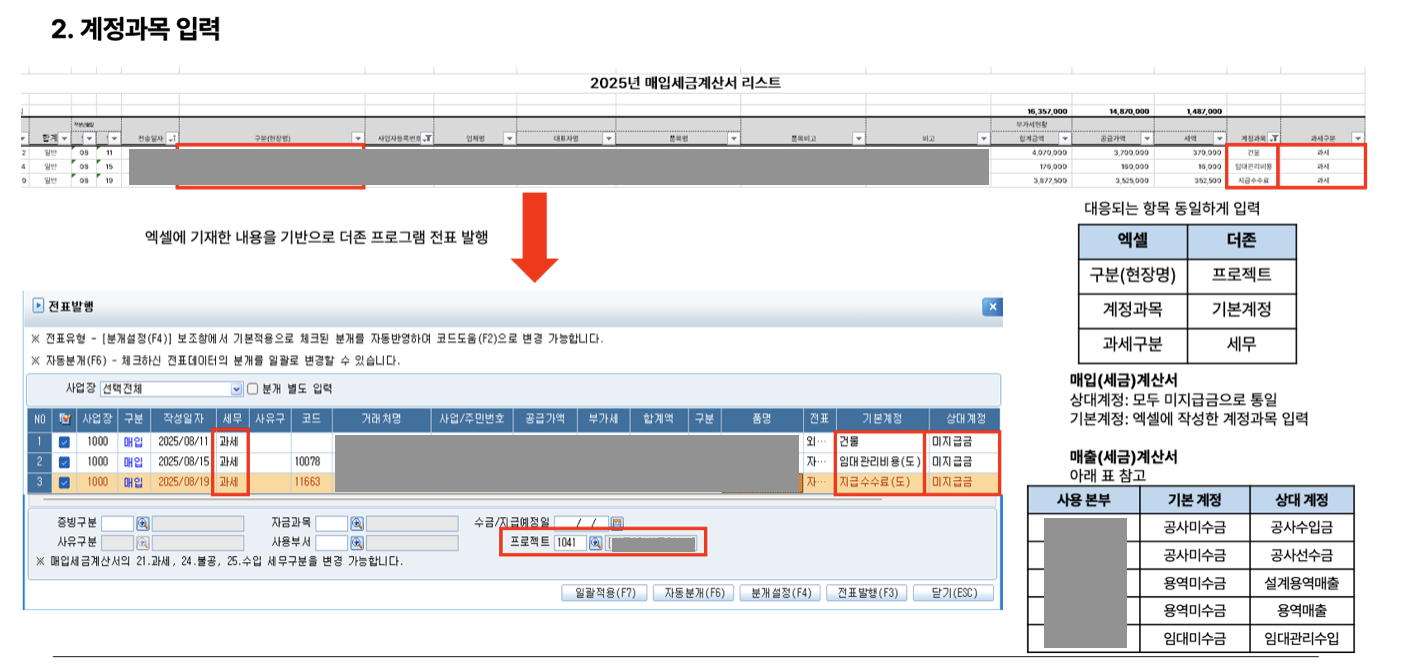
위 업무 요청을 위해 재무에서 만든 가이드 중 일부

홈택스와 엑셀과 회계 프로그램을 오가야하고, 없던 일이 생기는데다가 계정이니 뭐니 회계 용어도 알아야하고,,
게다가 본사 밖에선 회계 프로그램 이용을 위해서 VPN 까지 사용해야하니,,
그냥 포기해버리더라....ㅋㅋㅋㅋ

재무에선 점점 많아지는 일에 깔려 죽을라하고,, 각 부서에선 교육한다고 불러도 모르겠다고 멍 때리고 있고...
이렇게 삽질하고 있는걸 우연히 발견해서 해결해보기로 했다.

시스템 배경

이 회사에서 그룹웨어는 내가 만든 시스템을 사용하고 있는데, 그 기능 중 하나로 전자결재가 있고, 전자결재 이용 편의를 위해 홈택스 계산서 스크래핑 및 이를 첨부하는 기능이 있다.
단순히 가져와서 표시에 추가로 검색이나 수정 등 연관 계산서의 간편한 조회, 전자결재에 사용되었는지 여부 표시 등 이런저런 편의 기능이 들어가 있다. (좀만 다듬으면 다른 회사에도 팔아먹을 수 있지 않을까 생각했는데,, 팔기 위한 서비스 개발은 늘 어렵다ㅠㅜ)

해당 그룹웨어에 내가 구현해둔 세금계산서 조회 기능. 스크래핑도 직접 구현한 기능에 의존하다 보니 드물게 막힐 때가 있다ㅠ

아무튼 세금계산서 기능은 이미 있으니, 여기서 각 세금계산서에 대해 [프로젝트 설정, 과세 구분, 계정과목 설정] 기능을 지원해주고,
이렇게 입력된 정보를 [회계 프로그램에 밀어 넣어주기] 를 하는게 이번 프로젝트의 완성⭐️

그리고 블로그에서 이 카테고리의 취지가 그렇듯, 이 글을 쓰게 된 이유는 [회계 프로그램에 밀어 넣어주기] 와 관련되어 있다.

[프로젝트 설정, 과세 구분, 계정과목 설정]를 위한 프로젝트별 계정 과목 제약, 일괄 처리 등은 그냥 웹서비스로 만들면 되는거니까 대충 적당히 만들었다. 실무자들 불러다가 교육하고 피드백 정도가 남은 상황.


회계 프로그램

이 회사는 더X 사의 아이큐X 라는 시스템을 이용 중이다. (이름을 숨길 생각은 없지만 그렇다고 검색으로 떠서 좋을 것도 없으니 적당히 마스킹)

사내 PC 한대에 서버 프로그램 및 SQL Server 를 깔아두고, 각 작업자 PC 에선 이 서버로 접속해서 사용하는 구조이다.
최초 도입비를 좀 비싸게 받고, 이후엔 유지보수 비용으로 약간씩 받으며, 카드 등 스크래핑 모듈 정도는 주기적으로 업데이트 해주는 듯?

이전 지문 인식 소프트웨어가 그렇듯, 로컬에 설치된 서비스니까 접속 정보는 어떻게든 획득할 수 있다. 아니 그 이전에 그냥 인터넷에 공유가 되어 있더라.
다른 일로 이 회사 영업사원과 통화할 일이 있었는데, DB 직접 접속으로 활용하는건 다른 곳에서도 자주 있는 것 같더라. 회사 차원에서 반기진 않지만 그렇다고 막을 순 없으니 어쩔 수 없다,, 정도의 느낌? 차세대 서비스는 이런 문제가 좀 더 방어가 되어 있다고 하는데,,,

아무튼 이 서비스는 서버 PC에 대한 방화벽을 제대로 설정해두지 않으면, 비밀번호도 공개되어 있겠다 권한이 없는 직원도 데이터를 훔쳐갈 수 있는 상당히 취약한 구조이다. 물론 후술할 복잡한 작업을 다 했다는 가정하에. 현실적으론 일어나기 힘들 것 같긴 하다.
그래서 개인적으론 꽁꽁 막아두는 것 보단 이렇게 적당히 열려있어서 내가 손을 댈 수 있는 여지가 있는 환경을 선호한다 ㅎ
막아야 한다면 내가 막아도 되고...
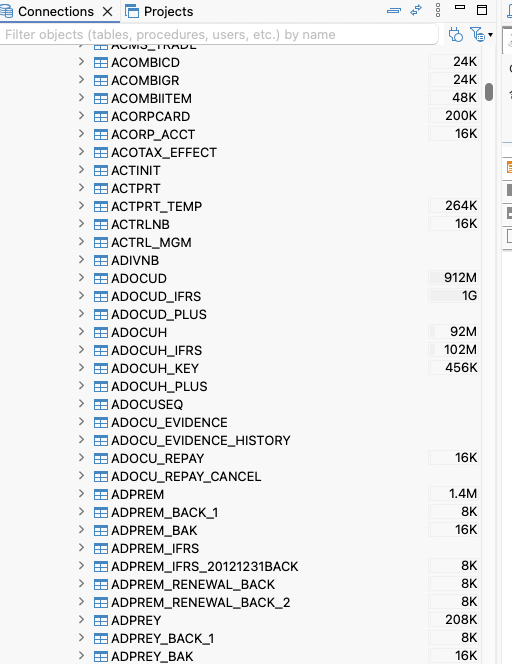
우리에겐 DB스키마 정보가 없으니,, DB 에 접속하면 불친절한 테이블명과 컬럼명들을 한가득 마주하게 된다.

사용량으로 테이블을 선별하고, 이름을 추론하고 데이터와 비교하면서 나에게 필요한 정보를 하나씩 찾는 지루한 작업...

컬럼을 하나 찾으면, 아래와 같은 쿼리로 동일 컬럼이 있는 다른 테이블을 찾을 수도 있다. 이 생각을 못해서 처음엔 하나하나 한참을 헤맸었다ㅠ

SELECT
    t.name AS table_name,
    c.name AS column_name
FROM sys.tables AS t
JOIN sys.columns AS c ON c.object_id = t.object_id
WHERE c.name = N'찾으려는컬럼명' AND EXISTS (
      SELECT 1
      FROM sys.dm_db_partition_stats AS ps
      WHERE ps.object_id = t.object_id AND ps.reserved_page_count > 0
)


헤매다보니 대충 DB 내에서 현재 수집된 세금계산서, 등록된 전표, 전표의 승인 여부 등 필요한 데이터는 얼추 찾았다.
완벽한건 아니지만,, 필요한 정보만 어떻게든 가져오면 되고 당장 정확성이 엄청 중요하지 않기 때문에, 문제 발생시 수정해주면 되고..


데이터 입력

문제는 데이터 밀어넣기.
어떤 테이블과 어떤 컬럼에 정확한 값을 넣어주지 않으면 프로그램이 오작동을 할 수도 있다.

이번에도 프로그램의 작동 로직을 분석하면 되는데,, 지금은 결국 DB에 기록되는거니, SQL 쿼리만 잘 찾으면 된다.

MSSQL 에는 Extended Events 란게 있다. 활성화해두면 실행된 쿼리 등에 대한 정보에 대한 로그가 설정한 경로에 기록되고, 이 파일에 대해 다시 쿼리로 이벤트를 조회할 수 있다.

다만 이걸 활성화하려면 sysadmin 권한이 있는 계정이어야 하는데, 위에서 말한 기본 계정은 해당 권한이 없다.
어차피 로컬 시스템이니까, 어찌저찌 생성해주면 된다. 이 과정은 생략.

-- 이벤트 생성
CREATE EVENT SESSION [TempSqlLog] ON SERVER
ADD EVENT sqlserver.rpc_completed( -- 프로시저 실행
    ACTION(sqlserver.client_app_name, sqlserver.client_hostname, sqlserver.database_name,  sqlserver.username)
),
ADD EVENT sqlserver.sql_batch_completed( -- SQL 쿼리 실행
    ACTION(sqlserver.client_app_name, sqlserver.client_hostname, sqlserver.database_name,  sqlserver.username)
)
ADD TARGET package0.event_file(
    SET filename = N'C:\SqlLog\SqlLog.xel',
        max_file_size = 100,
        max_rollover_files = 10
);

-- 시작/종료
ALTER EVENT SESSION [ShoSqlLog] ON SERVER STATE = START;
ALTER EVENT SESSION [ShoSqlLog] ON SERVER STATE = STOP;

sql_statement_completed 란 이벤트도 있었는데 유의미한 데이터가 없었던 것 같아서 제외, 오래전에 한거라 기억이 잘 나진 않는다.

action 에서 client_app_name, database_name, username 은 큰 의미는 없지만, 그냥 넣어뒀다. client_hostname 정도는 분석 과정에서 다른 사용자의 실 사용이 혼동되니 필터를 위해 사용했고..


로그를 켜두고, 전표 등록을 하고, 로그를 끄고, 이벤트를 질의한다.

WITH x AS (
    SELECT CAST(event_data AS xml) AS xe FROM sys.fn_xe_file_target_read_file('C:\SqlLog\SqlLog*.xel', NULL, NULL, NULL)
)
SELECT
    xe.value('(event/@name)[1]', 'nvarchar(60)') AS event_name,
    DATEADD(MINUTE, DATEDIFF(MINUTE, GETUTCDATE(), GETDATE()), xe.value('(event/@timestamp)[1]', 'datetime2(3)')) AS ts,
    COALESCE(
        xe.value('(event/data[@name="batch_text"]/value)[1]', 'nvarchar(max)'), -- sql_batch_completed
        xe.value('(event/data[@name="statement"]/value)[1]',  'nvarchar(max)')  -- rpc_completed (환경에 따라)
    ) AS sql_text
FROM x
WHERE
	xe.value('(event/action[@name="client_hostname"]/value)[1]', 'nvarchar(128)') = 'DESKTOP-....'
ORDER BY ts DESC;


이러면 실제 회계 프로그램이 실행하는 쿼리들을 확인할 수 있다.

내가 필요한 전표 입력엔 특정 프로시저를 호출하는걸 확인했다. 프로시저의 내부 쿼리는 암호화 저장되어 확인할 수 없었지만, 나도 똑같이 실행만 하면 되니까 프로시저의 내용물까진 필요없긴 하다.

이제 종류별로 전표 발행을 해보면서, 프로시저 호출시의 각 필드가 어떤 값인지 파악하고, 나도 동일하게 호출해주면 된다.


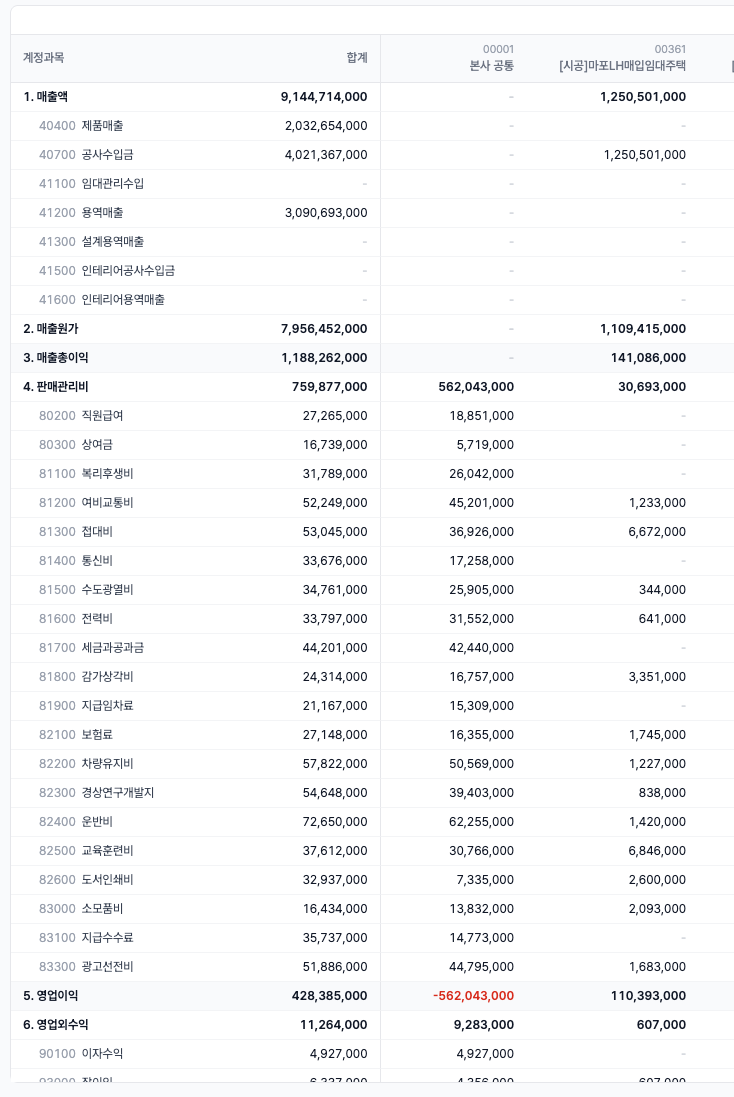
이렇게 데이터를 다루다보면 아래와 같은 재무제표들도 이것저것 만들어볼 수 있을 것 같긴 한데,,,
이건 아직 필요성을 못 느끼는 것 같기도 하고 나도 공부해야될게 많아져서 일단은 보류...

(아래 화면은 개발 중 시스템의 일부이긴 한데 값은 모두 AI 가 생성한 더미데이터이다.)
'프로젝트 모음' 카테고리의 다른 글

SUPREMA 지문 출입/근태기 연동  (0) 2026.09.21
전자책(EPUB) DRM 해제  (0) 2026.02.22
카테고리 프롤로그  (0) 2026.02.22

내가 몇몇 일을 봐주고 있는 회사 하나가 층별 출입 통제로 세콤 지문 단말을 사용하고 있었는데, 사옥을 리모델링하면서 8층은 엘리베이터에서 바로 접근이 가능해졌다.
그래서 엘리베이터에 8층 버튼은 그냥 눌러선 눌리지 않고, 지문 인증시에만 작동하도록 설치가 되어있었다.

그렇게 별 생각없이 살고 있었는데, 건물 관리 담당 직원을 보니 신규 직원 입퇴사시마다 건물 관리 보안용으로 세콤에 사용자 등록을 하고, 또 8층 엘리베이터 용으로 신규 직원들을 매번 모아 관리실에 가서 지문 등록을 또 따로 해주고 있더라.

지문 단말기는 Suprema 사의 BioStation L2 라는 장비로, 글 작성 시점 기준으론 지원 종료된 단말기이다.
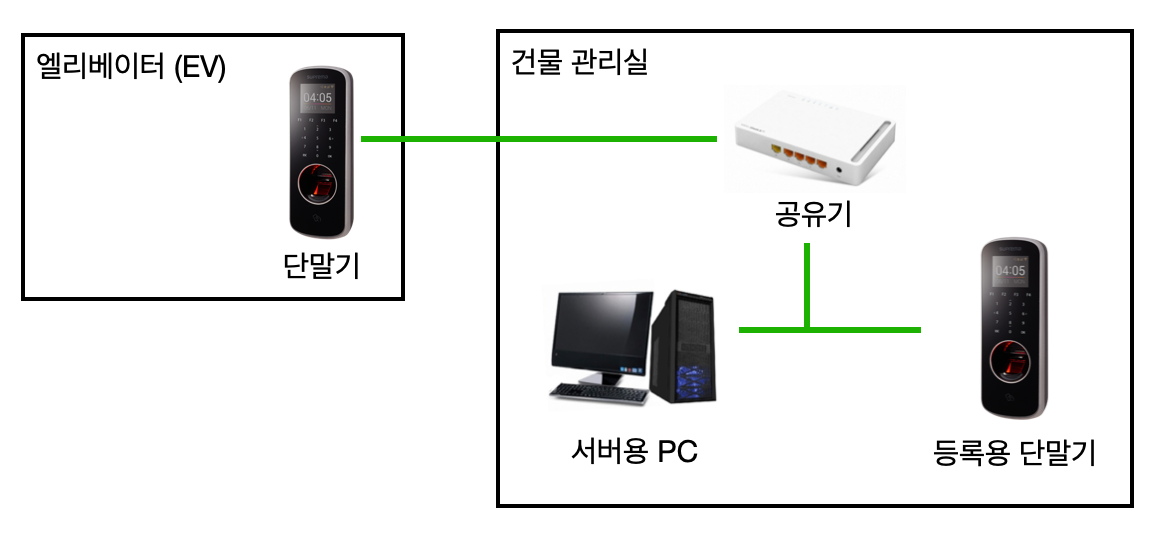
관리실에는 Windows 서버, 엘리베이터에 장착된 L2 단말기, 등록용 L2 단말기와 이들을 연결하는 공유기로 구성되어 있다.

대충 이런 구조..

담당 직원이 매번 관리실로 가야하는 이 비효율과 퇴사 지원의 관리 문제, 그냥 시스템에 대한 관심이 생겨서, 개선할 방법이 없나 이래저래 살펴보았다.


시스템 구조, 사용자/지문 등록 방법

서버 PC 에 어떻게 하는지 살펴보니, 웹브라우저로 관리 페이지에 접속해서 사용자 등록, 등록 과정에서 지문 스캔을 누르면 옆에 있는 등록용 단말기가 반응하고, 지문을 입력할 수 있는 구조였다.

서버 PC 에선 로컬에 MariaDB, java 등을 설치하고 웹 서버가 구동되고 있었고, 서버 내 DB 정보를 단말기 간에 동기화 해준다. 서버가 꺼져있어도 각 단말기는 직전 동기화 정보 기준으로 정상 작동함.

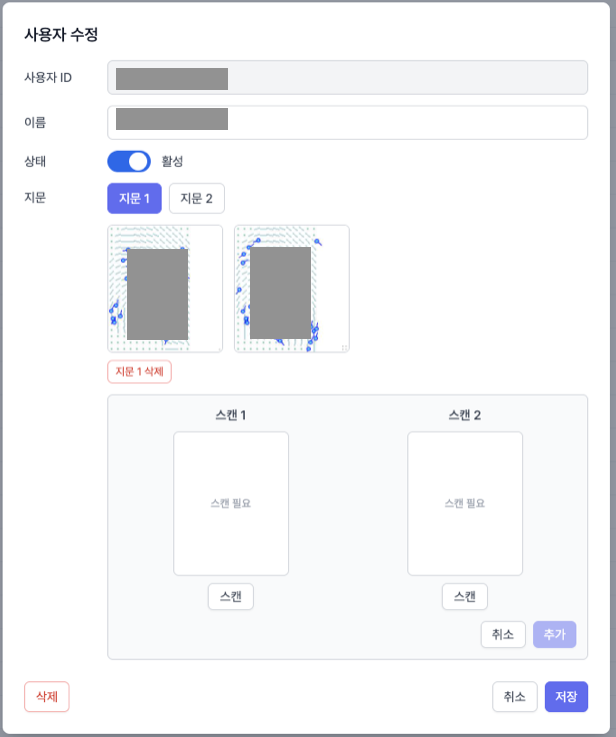
BioStar 2 라는 관리용 웹 콘솔과, 사용자 추가 화면

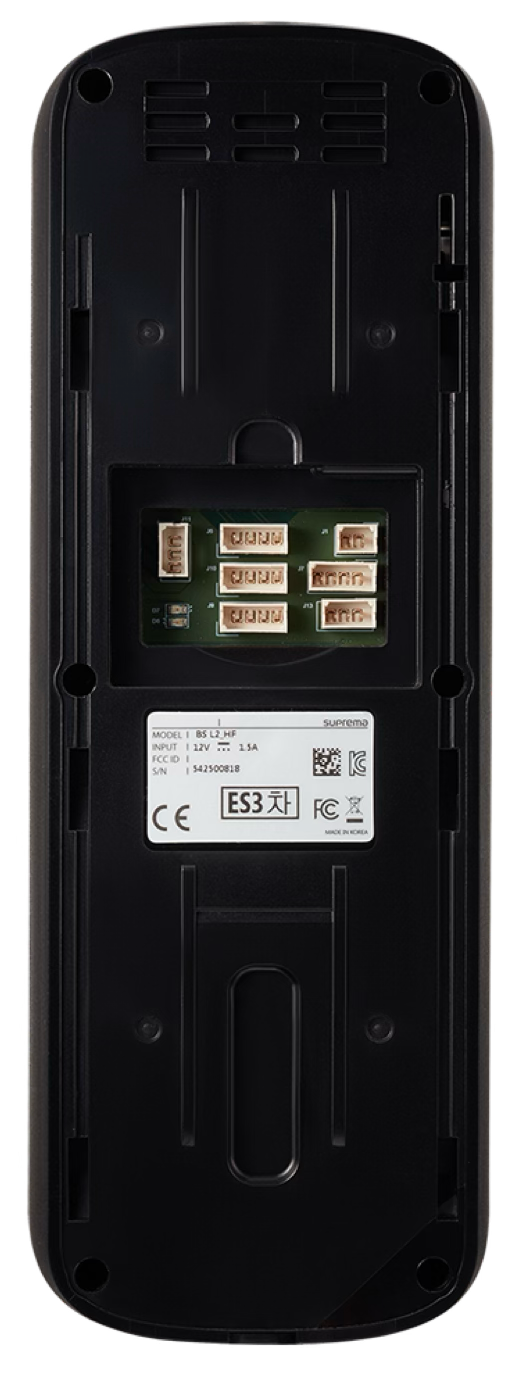
그리고 엘리베이터까지 뜯어보진 않았지만,, 단말기 뒷쪽을 보면 전원, LAN, 릴레이 신호 출력 등을 연결할 수 있는 웨이퍼 커넥터들이 달려있다.
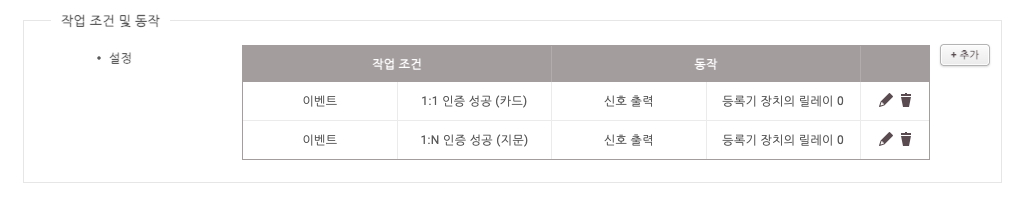
웹 장치 설정을 보면, 특정 이벤트마다 어떤 동작이 수행될지 정의할 수 있는데, 카드 / 지문 / PIN 등 각각 인증 성공시 릴레이로 신호 출력을 걸어둘 수 있다. 릴레이 출력에 문 개폐 등의 장치를 연결해두는 식인 듯. 우리는 엘리베이터에 8층이 눌리도록 배선되어 있겠지?


등록한 정보는 서버 PC 로컬에 설치된 MariaDB 에 저장된다.
사용자 관련 데이터는 암호화되어 있어서 DB 에 직접 접근해서 수정한다거나 읽어오는건 제한되지만 이 서버는 감사하게도 API 를 제공한다. 관련 내용은 아래에서 계속. 암호화 방식도 분석해서 복호화가 되긴 한다. 이 역시 아래에서 후술.


원격 접속

여튼 최초의 목적은 지문 하나 등록하자고 매번 관리실까지 내려가는 수고를 없애기!
서버 PC 의 웹서버에 접근할 수 있으면서, 지문 단말기가 그 서버 PC 와 같은 망에 있다면 관리실로 내려가는 수고를 없앨 수 있다.
두개의 망을 서로 연결하기 위해 사무실과 관리실까지 건물 내부 EPS 실에서 랜선을 내리니 마니 쌩쑈를 하다가,,

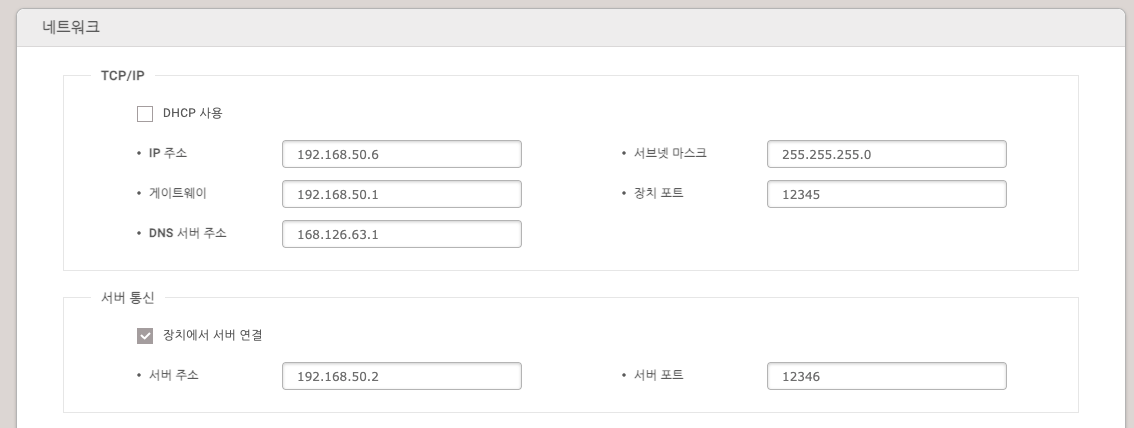
관리실의 공유기에서 서버PC 로 포트포워딩을 해두고, 단말에서 연결하는 서버의 주소를 공인 IP 로 설정해버렸다.

이렇게 하면 지문 단말도 어디에 있든 인터넷에만 연결되면 서버와 정상 연결이 된다.

‘장치에서 서버 연결’이 활성화되어있으면, 단말기에서 서버주소:포트/tcp 로 연결을 요청하고, 연결이 끊겼을 땐 10초? 30초? 잘 기억 안나는데 그 정도 텀을 두고 서버 연결을 시도한다.
연결 성공시 30초 단위로 ping 을 보내면서 연결을 유지하고, 서버에서 지문 인증 요청 등 요청을 보내면 이 채널을 통해서 단말로 명령을 보내고 단말이 작동하는 구조.

‘장치에서 서버 연결’을 끄는 경우엔 장치 포트가 사용되는 것 같은데, 굳이 테스트해보진 않았다.

등록용 단말기를 테스트한다고 집으로 가져왔는데, 여기서도 잘 작동하는 것을 확인…ㅎㅎㅎ
이제 관리실에 내려가지 않고도 지문 등록이 가능해졌다. 다만 서버 컴퓨터가 항상 켜져있어야 한다는 제약이 생김..

다만 BioStar 관리 웹페이지도 관리실 밖에서 접속이 가능하려면 설정이 추가로 필요하다. 기본적으론 해당 PC 에서만 접속이 가능하게 설정이 되어있기 때문.

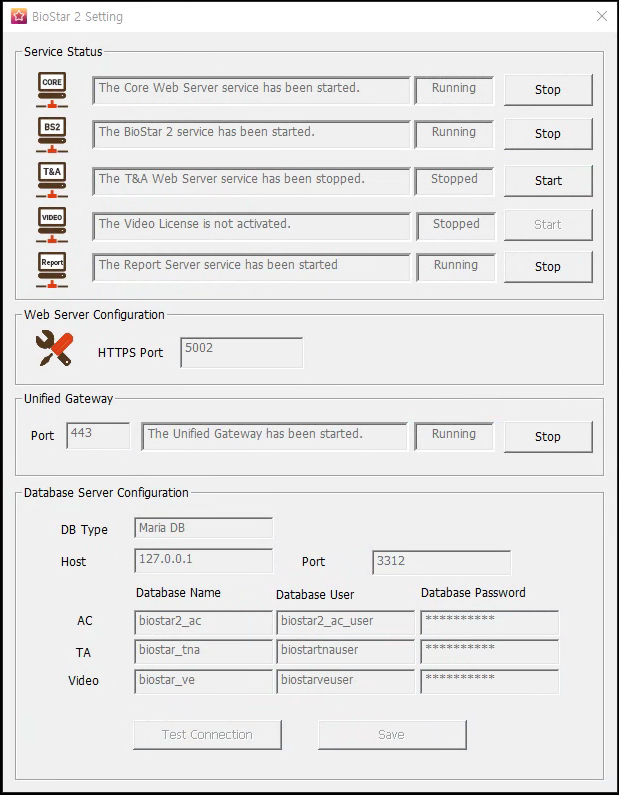
BioStar 2 Setting 이라는 프로그램을 실행해서 Unified Gateway 를 실행해주면 nginx 를 통해 웹서버가 다시 구동된다.
내 기억엔 이 과정에서 바로 전체 인터페이스로 바인드하니 포트 포워딩만 하면 접속이 가능했던 것으로 기억하지만,, 아니라도 nginx 는 설정 파일 변경이 용이하니 설치 디렉토리에서 nginx 를 찾아 설정을 변경해주자.


BioStar API

이제 관리실에 내려가지 않고, 사무실에서 관리 웹페이지에 직접 접근해서 작업해도 되지만,, 다음 목표는 퇴사자 등 인원 관리의 효율화이다.
위에서 말했듯 이 시스템은 API 를 제공한다. API 내용에 대해선
 BioStar X API 문서 참고.
위의 BioStar 2 제어용 웹사이트 자체도 이 API 를 기반으로 작동하는 것 같다.

API 가 완벽한건 아닌 것 같지만,,, 사용자 목록 조회, 사용자 수정(지문 추가 등)/비활성화/삭제, 기기로 지문 스캔 요청 등은 모두 가능하다.
사용자 관리야 그러려니하고, 지문 등록 기준으론 다음 과정을 거치면 된다. 한개의 지문(fingerprint)은 등록시 2개의 스캔 결과(template)가 필요하다. 이는 이 가이드 - [BioStar 2 API] How to Add Fingerprint Credential to a User 에서 세부적으로 잘 알려주고 있다.

  1. 지문 스캔 두번 - Scan Fingerprint
    • API 를 호출하면, 요청에서 선택한 기기로 지문 인식해달라는 메시지가 바로 표시된다.
    • 정상 스캔시 지문의 퀄리티가 기준치를 충족하는지 확인. Web 에서 기본값은 80인 듯, API 이용한다면 직접 검증 필요
  2. 이미 등록된 지문과 일치하는 template인지 확인 - Verify Duplicate Fingerprint
    • 단말로 요청을 보내지 않고 서버에서 검사
  3. 스캔한 2개의 지문(template)이 동일한 지문이 맞는지 검증 - Verify Fingerprint Scan
  4. 사용자 정보에 해당 지문(2개의 template 쌍) 추가하여 수정 - User: Update
    • fingerprint_templates 에 기존값 포함하여 추가

이대로만 끝냈으면 글을 쓰지도 않았을 것,, 시스템 자체에 관심이 생겨서 좀 더 살펴봤다.

DB 암·복호화

로컬에 설치된 DB 는 어찌저찌 접속해도, 사용자 정보에 관한 부분은 대부분 암호화되어 있다.

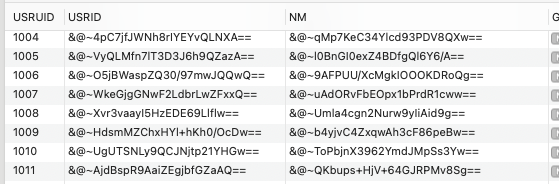
biostar2_ac.t_usr

눈으로 보이다시피, &@~ 로 시작하면 암호화된 데이터.
BioStar 설치 폴더/util/enckey 에 BioStar.secure_communication.encryption_key 로 암호화를 하는데, 이 키를 그대로 쓰진 않고 여기다가 xor 및 시저 암호를 간단히 적용하여 key, iv 를 만들어낸다. AES + PKCS7 패딩으로 각 record 를 복호화하면 됨.

사실 API 로 가져오면 되니까 크게 필요는 없기도 하다.
이 DB를 그대로 쓴다면, 기기 동기화 시켜야하니 API 호출이 어차피 필요해지는데 API 상으로 사용자 정보는 충분히 잘 제공해준다.

API 서버를 안쓰고 자체 프로토콜로 구현한다고 치면 이 DB 를 쳐다볼 필요도 없고,,,

그래도 일단 작업해본 김에 이렇게 정말 간단하게만 남겨둠.


통신 프로토콜 분석

Suprema 는 위에서 내가 사용한, BioStar 2 서버를 사용하지 않고도 단말기를 제어할 수 있게 Device SDK 란걸 제공한다.
관련 문서는 BioStar Device SDK 에서 확인할 수 있고, 샘플 코드와 Windows/Linux 각 32bit/64bit 라이브러리를 제공한다. (ARM은 없지만…)

위에서 얘기한, ‘장치에서 서버 연결’ 를 설정해두면 기기에서 서버의 tcp 포트로 소켓을 연결한다. 초기 키 교환 이후 요청은 AES로 암호화하여 주고받는다.

  1. 서버는 연결되자마자 32B source_key 를 고정 키로 암호화하여 응답 반환
  2. 장비는 source_key 를 해싱하여 key, iv 생성, 이 후 상호 통신 간엔 AES-256-CBC 로 암호화하여 통신
    • 평문 20B + 암호화 데이터{ 헤더 16B + Payload }

SDK 에 통신 프로토콜에 대한 구조는 없어서, SDK 없이 직접 구현은 좀 까다롭다.

양측 통신을 서로 비교하고 SDK 문서나 구현을 참고하여 어찌저찌 Python 에서 작동하는 서버를 거의 다 만들었는데,,
새로 스캔한 지문 template 이 이미 등록된 지문인지 확인할 방법이 없다ㅠ (슈프리마에선 1:N 인증이라고 부르는 듯.)

위의 등록 과정에서 [2. 이미 등록된 지문과 일치하는 template인지 확인 - Verify Duplicate Fingerprint] 과정에 해당하는 구현인데,,
1:1 비교는 두 템플릿을 단말로 보내서 결과값을 받으니 기존 서버없이 사용이 가능한데, 1:N 인증에 대한 기능은 없다. 단말에 저장된 정보 기준으로 검사 및 반환이 가능할 것 같은데 말이지..ㅠㅠ

OSDP 라고, 다른 출입통제 시스템과 연동 사용하는 매뉴얼도 있던데 여기서도 2개 템플릿이 일치하는지 검사하는, 1:1 비교만을 지원한다.
템플릿 하나로 이게 등록된 사용자의 지문인지 비교하는
1:N 비교는 제공하지 않는다...

이 기능 하나가 없어서 기껏 만든게 모두 도로묵...ㅠㅠㅠ
의도적으로 제공하지 않는 것 같은데 이유는 잘 모르겠다.


지문 template 분석

지문 검사를 내가 직접해줄 순 없을까? 싶기도 하고 이 쯤 오니 궁금해져서, 지문 template 데이터도 분석해봤다.
template은 지문 스캔 이미지를 일부 전처리한 후 융선과 특징점을 추출한 데이터로, 최대 384B 의 데이터를 base64 인코딩되어 있다.

설정에 ISO (ISO 19794-2 일 듯), ANSI378 이란 포맷도 있던데,, 현재 기본 값은 Suprema 포맷.
OSDP 로 ANSI 포맷을 사용할 때도 템플릿은 최대 384B 로 제한하라는 문서가 있다. 내부 처리 한계인 듯.

Suprema 포맷은 UF Template 이라고도 불리는 것 같다.(그래서 이하 UF 포맷) 과거엔 UFMatcher.dll 이란 이름으로 별도 배포되다가, 지금은 biostar-server.exe 내부에 구현이 포함되어 있다.

UF 는 헤더(8B) + 특징점(4~5B * 개수) + 융선 방향장(셀 개수 만큼)으로 구성되어 있다.
헤더에 셀의 크기가 적혀있고, 1 ~ 63의 범위로 검사하지만, 내가 테스트한 장비 기준으론 지문 원본 이미지가 272x320(17x20 셀), template 이미지는 288x320(18x20 셀) 로 출력해주고 있었다.
템플릿 이미지가 오른쪽에 여백을 줄지언정 288px 로 고정출력되는거 보면 이게 최대 크기인 것 같긴 한데,, 다른 모델이면 더 큰 해상도로 줄 지는 모르는 일...

특징점은 셀이 아니라 template 이미지 기준(288x320) 특정 좌표와 거기서의 360도 각도 값, type 으로 추정되는 0, 1값, 그리고 비교할 때 사용하는 7비트 속성으로 이루어져있고,
융선은 셀 개수(18x20)만큼, 각 셀을 방향없이 길게 채우는 degree 값을 사용한다.

각 값들은 압축 정도에 따라 표시 범위가 제한되기도 하지만 그런거까진 생략.

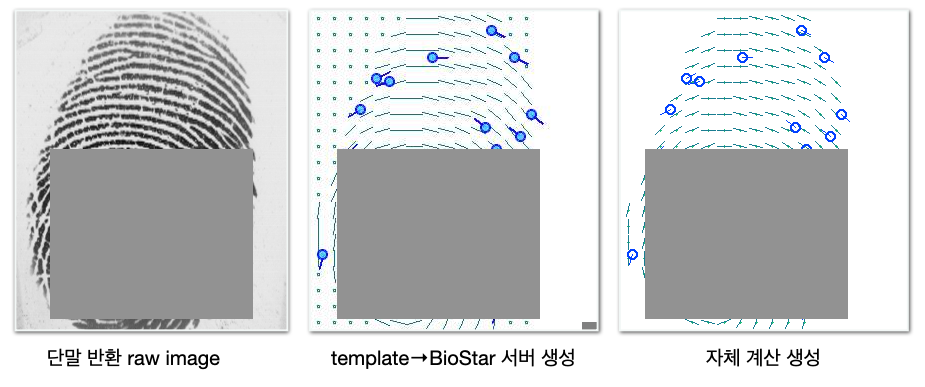
지문 원본 이미지는 회색 음영인 PGM 포맷이고, 설정에서 지문 - 이미지 표시 활성화시 단말 기기에서 바로 볼 수 있는 이미지이다.
이 raw 이미지는 스캔시 받을 수 있도록 API 구조에 있긴 한데, 실제로 이미지를 주진 않았던 같다. (이런식으로 API 가 뭔가 구멍이 하나씩 빠져있다..ㅠ) 난 SDK 구현 이용해서 가져옴.

웹이나 API 사용시 기본적으로 template 을 이미지로 변환한, 두번째 형태의 이미지를 준다.

template 구조를 분석하면 3번째 이미지를 자체적으로 생성할 수도 있음. 세부 구조 분석 결과는 생략.


회사 그룹웨어에 구현

일단 다시 구현한 매칭 알고리즘을 사용하진 않고, BioStar API 만을 사용해서 회사 그룹웨어에 지문 등록, 수정 기능을 만들어두었다.
일단 이대로도 쓰는데 지장은 없지만,, 나중에 심심하면 좀 더 개선해봐야지...

장비만 좀 저렴하면 다른 용도(법인차량 키나 인감 도장 불출 등)로도 써먹고 싶은데, 인식기 대당 가격이 비싸서.. ㅠㅠㅠㅠ


매칭 알고리즘 분석

기능을 제공하지 않아서 답답하기도 하고, 수백명의 지문에서 어떻게 비교해서 결과를 내는지도 궁금해서 이것도 분석을 진행해봤다.

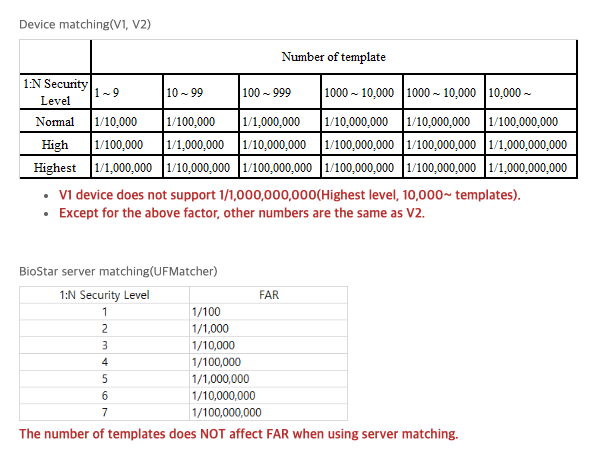
슈프리마 지원 문서에서는 FAR(다른 사람의 지문인데 오인식 매칭되는 확률)에 대한 문서가 있다.

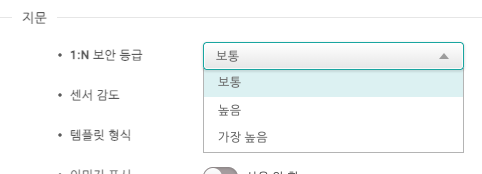
1:N 보안 등급이 단말기 입장에선 보통, 높음, 가장 높음으로 구분되고, 서버에서 UFMatcher 가 비교하는건 1~7단계의 보안 등급이 있는 것 같다.

BioStar 웹 기기 설정 페이지에서의 지문 1:N 보안 등급 설정 메뉴

서버 매칭은 지문 개수에 따른 차이가 없긴 한데,, 느낌상 단말의 보통 = 서버 3, 단말 높음 = 서버 4, 단말 가장 높음 = 서버 5와 유사한 수준을 제공하나보다.
이 회사의 환경에서 기의 1:N 보안 등급은 보통으로 설정되어 있었고, 서버는 설정값을 찾진 못했지만 보안 레벨이 5로 작동하고 있었다.

이렇듯 서버와 단말기의 알고리즘이 조금 다른거 같긴 한데,, 단말기 로직 분석은 너무 어려울 것 같으니 서버 로직 분석만 진행.
ANSI 등 포맷의 검증 로직도 있지만 일단 난 UF 포맷만 확인하였음.

1:N 비교는 최악의 경우엔 전체 지문과 다 1:1 비교를 해야하더라. 대강 다음 순서로 진행된다.

  1. A, B 각 템플릿의 UF 포맷 헤더 상 특정 1B(raw[4]) 값의 차이를 구한다, 이 값의 절댓값이 낮은 순서부터 검사를 진행한다.
  2. 1차 비교
    • Fast 모드: 특징점을 최대 18개로 줄인 뒤, 거리(7)/상대 방향(20도) 오차 조건으로 대응점을 찾고 점수 계산, 50점 미만이면 탈락
    • 기본: 좀 더 엄격한 거리(4)/상대 방향(15도) 오차로 대응점을 찾고, 특징점 쌍 개수가 많으면 거리가 먼 쌍은 일부 제외, 60점 미만이면 탈락
  3. 2차 비교
    • 전체 특징점에 대해 거리(7)/상대 방향(20) 오차 조건으로 대응점을 찾고 점수 계산
    • 보안 등급에 따라 특정 점수(등급 5는 350점) 이상이면 합격
  4. 전체에서 최고점수를 찾진 않고, 보안 등급별 기준 점수를 넘기는 첫번째 항목이 나오면 해당 항목 반환
  5. 1:1 검증에서, 혹은 1:N 검증에서 일치 후보를 찾지 못했으며, 관련 설정이 켜져있는 경우(난 꺼져있음), 템플릿을 특정 로직으로 변환한 후 재검증

2번 이후야 결국 1:1 검사인 셈이고, 많은 지문 중에 어떻게 대상 지문을 빠르게 찾아내나 했는데, 1번 과정이 핵심인 것 같다.
저 1바이트의 값을 어떻게 생성하는지는 모름,,, 아쉽게도 지문 이미지 → 템플릿으로의 변환은 서버에 없고 단말에서만 수행하는 것 같다.

서버 쪽 설정은 여전히 없지만,, 단말 설정 기준 1:N Fast 모드가 자동, 보통, 빠름, 가장 빠름이 있다.
추정컨데, 가장 빠름: 1차 비교 + Fast 모드 / 빠름: 1차 비교 / 보통: 1차 비교 자체를 생략; 이지 않을까..?
현재 서버에선 1차 비교를 하되 Fast 모드 리샘플링은 안하더라.


얼추 따라 구현하긴 했는데,, 어차피 당장 사용할 구현은 아니라서 자세한 검증을 해보진 않았다.


이제 지문 이미지에서 template 으로 변환하는 로직만 알아내면 슈프리마 시스템과 호환되는 완전 자체 제작 장비를 만들 수도 있겠지만,,,!
나 혼자 쓰는거 외에 다른 곳에 쓸 수 있는 것도 아니고,, 그렇게 호환시킬거면 ANSI 포맷 같은걸 쓰면 되는게 아닌가,, 싶다..

최근에 디미고 학생이 지문 모듈로 교내 간편결제 솔루션을 만들었다는걸 보고 지문 인식 방식에 조금 관심이 있던 찰나 마침 이걸 하게 되어서 좀 더 쓸데없이 시간을 과투자하긴 했는데,, 뭐 나름 재밌었다.
나도 대학생 때 비슷한걸 하고 싶었지만 법적인 문제와 결국 은행과의 연동에서 포기했는데,, 디미고나 민사고에선 이걸(특히 법) 어떻게 해결했나 몰라,,, 그냥 따로 입금받고 학생이란 쉴드로 적당히 넘어가고 있으려나? ㅎㅎㅎㅎ

들어가기에 앞서,
- 구매한 도서를 본인의 능력으로 직접 DRM을 해제한 경우는 국내법상 합법으로 알고 있습니다.
- 다른 사람이 도와주거나 대신 해제해준 경우 불법입니다.
- 구매가 아닌 대여 도서의 해제도 당연히 불법이겠죠?
이 글은 작업의 기록이지 세부 내용이나 방법은 다루지 않습니다.


솔직히 난 종이책이든 이북이든 책을 잘 읽지 않는다.
그렇지만, 우연히 지인의 이북 리더기를 보았는데 갖고 싶다는 생각이 들었다.
모델명은 물어보지 않았지만, 아마 오닉스 포크6 인 것 같은데,, 가볍고 생각보다 빠른 화면 전환...

오닉스 포크6 상품페이지에서 발췌, 보따리상 지들도 중국 소개 긁어오면서 템플릿 마냥 자기 상호 워터마크 밖은게 참 같잖다. 같은 이미지 워터마크만 다른 상품페이지가 한가득...

그래서 어떤 제품이 있을까 뒤적이다가, 뜬금없이 epub drm 에 꽂혔다.
이북리더를 산들, drm 에 묶인 전자책을 전용 뷰어앱으로만 보고 싶진 않았거든.

옛날 옛적에 리디북스의 DRM 해제에 대한 방법과 코드가 공개된 적이 있었다.
블로그 글은 사이트가 날아간 것 같고, 깃헙은 남아있네 - https://github.com/disjukr/ridi-drm-remover


GitHub - disjukr/ridi-drm-remover: https://www.bpak.org/blog/2018/04/%EB%A6%AC%EB%94%94%EB%B6%81%EC%8A%A4-%EC%9E%90%EC%8B%A0%EC%

https://www.bpak.org/blog/2018/04/%EB%A6%AC%EB%94%94%EB%B6%81%EC%8A%A4-%EC%9E%90%EC%8B%A0%EC%9D%B4-%EC%86%8C%EC%9C%A0%ED%95%9C-%EC%B1%85-drm-%ED%95%B4%EC%A0%9C%ED%95%98%EA%B8%B0-feat-%EC%9C%84%ED%9...

github.com

저분은 무슨 깡으로 저런걸 공개했는지 모르겠지만,, 나도 당시에 코드를 받아 한권 정도 재미로 풀어봤었다.
이게 생각이 나서, 나도 DRM을 풀어서 소장해야겠다.. 라는 이상한 의식의 흐름이랄까.
그래서 시작된, 이북리더 구매도 전에 EPUB DRM 부터 해제하기!

플랫폼마다 난이도는 천차만별일거라,, 일단은 EPUB 의 DRM 대해 공부해볼겸 만만하게 공공도서관의 전자책 대여 시스템을 타겟으로 삼았다. 물론 대여한 도서의 DRM 제거는 빼박 불법이겠지만,, DRM 기술에 대한 학습 목적으로...?
난 취미삼아 다른 서비스들 리버싱을 종종 해보는데, 그러면서 배우는게 꽤 많았던 것 같다.

그리고 미리 전자책 업체에 대한 변명을 해주자면,, 소프트웨어에서 창과 방패의 싸움에서는 절대적으로 창이 유리하다.
특히 전자책과 같이 소프트웨어와 컨텐츠가 사용자 기기로 내려받아지고, 로컬 기기에서 복호화를 해서 내용을 표시하는 경우엔 무조건 뚫릴 수 밖에 없다. (극단적으론 책 한장한장 다 사진 찍어서 만들면 그걸 어떻게 막을 것인가?)

그래서 기술 외적으로 사법의 힘을 빌려 처벌하거나, 최대한 귀찮게 만들어 효용 가치를 사라지게 하는 방법이 유효하다. OTT 서비스가 부상하면서 쉽게 VOD를 볼 수 있게 되자 웹하드나 토렌트가 상당히 죽은 것과 비슷하달까?
그러니 이렇게 뚫린다고 해서 그 기관이나 개발사를 괴롭히는 일은 없었으면 좋겠다..


가장 먼저 해볼 일은, 책을 구매하든 대출하든 전용 뷰어로 열어보는 일이다.
그래야 중간에서 컨텐츠를 훔치던가 복호화를 하던가 할 수 있으니까...
나쁜 업체, 하지만 내 입장에선 고마운 업체가 대충 만들면 중간 네트워크 패킷을 훔치는 것만으로 DRM 프리한 컨텐츠를 그대로 얻을 수 있을지도 모른다.

그러다보니, 훔쳐보지 못하게 하는 보안 기술 중에 SSL Pinning 이란 것도 있다. 이걸 적용하는 경우는 잘 없는데,, 좀 의외...
물론 창이 유리하다고 했지? 이런 것도 우회할 수 있다.
그래도 환경에 따라 우회가 상당히 제한되기도 하고 방법이 더 복잡해지기 때문에, 이런 조치만으로도 나같은 툴 키디의 공격으로부터 서비스를 보호할 수 있게 된다.
다른 OS에서 SSL pinning 을 우회활 방법을 만들어 뒀었기에 OS 를 바꿨는데,
다른 OS의 앱에선 pinning 이 안걸려 있어서 편하게 바로 스니핑이 가능했다.

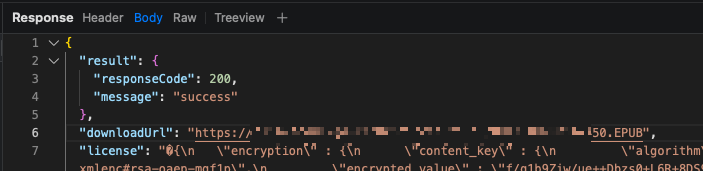
뷰어 앱에서 전자책을 열람할 때마다 서버에서 받아오는 응답의 일부

얘들은 로그인 인증이 개판이라 이런건 좀 혼나도 될 것 같긴 한데,, 지금 중요한건 아니니 넘어가도록 하자.
주고 받는 패킷에 epub 주소가 있고, 그냥 다운받아 쓰고 있다. '어라? 그냥 저 epub 를 다운받아주기만 하면 되나?'

까비~
파일을 열어보니 신기하게 파일이 통째로 암호화된게 아니다. 뷰어에서도 책의 이름은 정상적으로 가져오더라.

EPUB 는 컨테이너로 zip 을 사용하고 있어서, 확장자만 zip 으로 바꾸면 압축파일처럼 내부 파일이 풀린다.
그 안에 책에 대한 정보나 이미지, 본문 텍스트 등이 있는 구조인데, 기본 정보 외에 폰트, 이미지, 텍스트는 모두 암호화된 상태였다.
도서를 한번 열람하면 앱 내부에 .epub 파일을 .zip 으로 저장하던데, 아쉽게도 암호화는 유지한 상태로 저장을 하고 있었다. 책을 열 때 마다 복호화하는 구조.

xml 구조인 메타 데이터 내에서 눈에 띄는 키워드로 검색해보니 EPUB 의 DRM 에 주로 사용되는 표준 암호화 방식이 있더라.

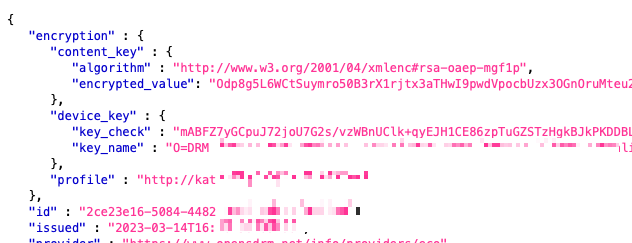
EPUB 파일 내부 META-INF/license.lcpl
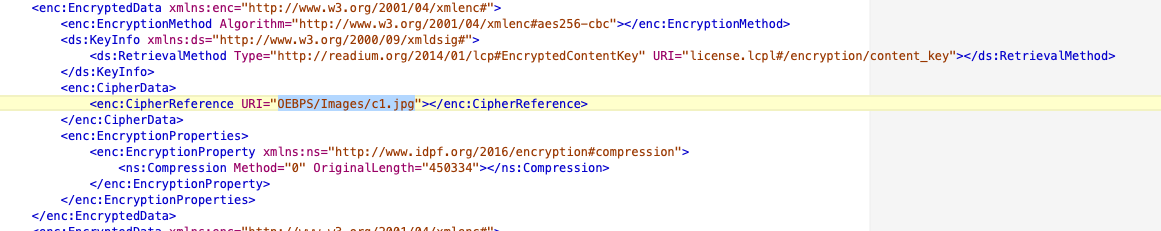
EPUB/META-INF/encryption.xml

대충 정리하면 리소스는 각 aes 암호화가 되어 있으면서, 그 aes 키는 license 파일에 다른 키로 암호화된 상태로 저장되는 구조였다.
암호화 하는 다른 키는 구현하기 나름이겠지만, 내가 본 업체는 RSA 키로 암호화가 되어 있었다.

조금 특이한건, 서버에서 내려주는 epub 파일 자체는 키가 없어서 내가 복호화할 수 없는 license 파일이다. 대신 도서를 열 때 내 기기에 저장된 RSA 키 페어 인증서를 서버에 보내는데, 그 때 내 공개키로 암호화된 값을 가진 새 license 파일만 내려준다.
그러면 앱은 로컬에 저장된 epub 내의 license 파일을 서버에서 새로 내려준 파일로 덮어씌운채로 저장해둔다.

리소스 자체는 aes, 즉 대칭키로 암호화되어 있기 때문에, 라이선스 파일이 교체되지만, epub 리소스를 복호화 하기 위한 키 자체는 고정된 동일한 값이다. 어차피 한번만 복호화 키를 얻으면, 완전 복호화한채로 저장하면 되기 때문에 뭔들...


이제 남은건 2가지.
1. 뷰어 앱 혹은 기기에 저장된 개인키
2. 복호화 방식

개인키를 추출하는데 가장 오래걸렸는데,, 결국 내 기기에 설치된 뷰어 앱이 해당 개인키로 복호화를 하기 때문에, 어딘가엔 있다. 굳이 꺼낼 수 있는 방법이 마련되어 있지 않을 뿐. 어디에 있는지 모르기 때문에 찾는게 좀 귀찮다.
드물게 하드웨어에 키를 저장하고 사용하는 방식의 경우 키 추출이 불가한 경우도 있는데, 다행히 그렇진 않았다.(보통 잘 안쓴다.)
저장소 자체가 어디인지는 찾지 못한게 아쉽지만,,, 뷰어앱도 결국 복호화를 위해 비밀키를 메모리로 불러오기 때문에 그 과정에서 키를 가로채는게 가능하다.

내가 분석한 앱은 앱 자체는 하는 작업이 거의 없는 가벼운 앱이었고, DRM 프레임워크가 앱 용량의 대부분을 차지하고 있었다.
멀티플랫폼 지원용인지, OpenSSL 을 프레임워크 내에 내장하고 있더라.

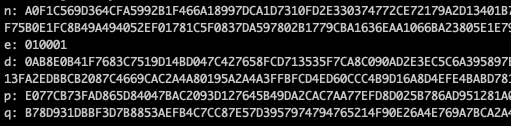
시간이 조금 걸렸지만, 어쨋든 비밀키 추출 성공!
난 리버싱을 잘하는건 아니라서, 비효율적인 편법을 주로 사용한다. 상당한 노가다를 동반한다고 생각하면 됨.
위에서 서버에 보내는 내 기기 인증서의 키와 페어임도 확인했다.

RSA 비밀키는 e, p, q, d 로 구성된다. N은 p,q 로 만드는거고...

참고로 복호화는 키가 틀려도 일단 복호화 자체는 문제없이 된다. 결과물이 쓰레기일 뿐...
그래서 키가 올바른 키인지 검증 과정이 따로 필요한데, 라이센스 파일의 encryption.device_key.key_check 값을 비밀키로 복호화하면 license 파일의 id 와 동일한 값이 튀어나온다. 이를 통해 올바른 키인지 확인할 수 있다.

조금 특이한건, 암호화 과정에서 보통 PKCS7 패딩을 많이 쓰는데,, ISO 10126 패딩인 것 같더라?
리버싱으로 복호화를 할 땐 기껏 키를 찾고 나면 iv와 패딩을 찾는데도 꽤나 시간을 쓰기도 한다. 이번엔 다행히 쉽게 해결함.


그 후에 찾은 복호화 방식은 비교적 간단했다.
encryption.content_key.encrypted_value 를 내 개인키로 복호화하면 32바이트 키가 나오고, 이를 이용해 리소스 파일들을 각각 복호화하면 된다.
기술적으론 암호화 키를 여러개 사용할 수도 있나본데, 어차피 하나만 쓰고 있으니 그런 경우는 무시.
먼저 압축한 후 암호화된 경우도 있으나 이 정보도 xml 에 기록되어 있으니 적절히 리소스에 따라 복호화 및 압축 해제해주기...

복호화 방식을 알고 비밀키가 있으니, 나머지 과정은 자동화할 수 있다.
대여/구매한 책의 라이선스 키를 받고, 암호화된 epub 를 다운받은 뒤 복호화까지 한방에 하는 스크립트 작성이 가능하단 의미.

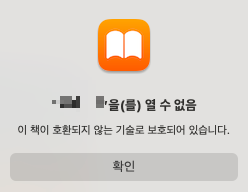
drm 해제가 완료되면 평범한 epub 파일이 된다. epub 포매을 지원하는 어떠한 앱(나의 경우엔 애플 도서 앱)으로도 볼 수 있다.

법의 보호를 받는 친구다. 나에겐 적법한 권리가 없는 저작물이고 학습 목적으로 잘 활용했으니 완전히 삭제해주도록 하자


근데 여긴 아쉽게도 내가 읽고 싶은 책이 없네.

그냥 poc 삼아, drm 구현의 공부 삼아 대출 도서로 진행해봤다.
실제론 이북으로 구매하고 그 구매한 책을 대상으로 사용할 예정인데, 업체마다 DRM의 구현 방법은 다 제각각이기 때문에, 완전 처음부터 다시 분석해야하고 방법이 완전 다를 가능성도 있다.
운 좋으면 같은 외주사가 개발했다거나,, 사용 기술이 비슷해서 날먹할 수도 있지만....

어쨋든 시도해보기 전엔 난이도를 알 수 없는데, 부디 내가 쉬운 이북 업체를 잘 찍기를 바라보며,,,
다른 서비스의 DRM 해제는 이북리더를 진짜 사게되면 진행해봐야겠다.


이북리더도 구매했겠다, 진짜 사용을 위해 다른 업체에서 진행해보았다.

얘들은 DRM 업체의 솔루션을 구매해서 사용하고 있던데, 이 시스템이 서버와 통신하는 방식이 조금 특이하다

처음 요청을 보내면 라이센스 서버의 인증서와 nonce 를 반환하고, 클라이언트는
1. random 16B 생성, key 로 사용
2. nonce+사용자아이디를 1번의 키로 암호화 = password
3. 1번의 키를 서버가 준 라이센스 서버의 인증서로 암호화 = KEK
4. 이를 서버로 다시 전송
하는 과정을 거친다.

아마 솔루션 자체가 HTTPS 가 대중화되지 않았던 과거에 만들어진 후 아직 그대로 사용하는게 아닐까 싶다.

또 이상한건, 위 업체처럼 기기의 비대칭키와 인증서를 생성하게 되는데, 이 키를 서버에서 생성해서 내려준다..ㅡㅡ;;
암호화된 pkcs8 로 내려주는데,, 이 암호도 요청에 포함이 되어 있고.............

비대칭키 쓸 때 대표적으로 하지 말라는 모델 아닌가,, CSR 같은건 왜 안쓰고.... (물론 위에 처음 뚫어본 업체도 그랬을 수도 있지만,, 확인해보지 않았다)
이런거 역시 옛날에 솔루션이 만들어졌다고 생각하면 클라이언트에서 키 만들기 어려웠던 시절도 있으니까, 일단은 그러려니......

여튼 그러고나면 얘들도 암호화된 .epub 파일과 license 파일을 내려받는다.
license 파일은 비슷한 듯 다른데, 어쨋든 기기의 비대칭키로 복호화할 수 있는 값을 가지고 있다.

얘들은 epub 자체도 자체 기술로 암호화되어 있고, 암호화를 풀면 내부 리소스 중 일부 데이터(주로 텍스트 위주)가 한번 더 암호화되어 있다. 겉 암호화는 풀어서 기기 내부에 저장하고 있으니, 이런 형태를 취했나 싶긴 한데.. 좀 이상하긴 함

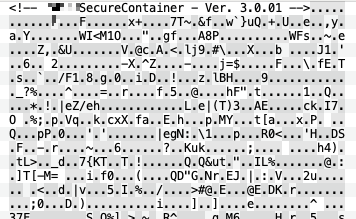
암호화된 파일은 이렇게 생겼다. 파일 헤더에 html 스타일 주석이 있고 뒤에 바이너리 데이터 주루륵

아무튼 또다시 자세한건 생략. 이번엔 정당한 이용을 위해(?) 책을 구매하고, 구매한 책의 DRM을 해제하였다.

군대에 있을 때 병영 도서관에서 읽고 마음에 들어서 실물 책을 따로 구매했던 강세형 작가님의 [나는 다만, 조금 느릴 뿐이다]. 그 책보다 먼저 출간했던 책


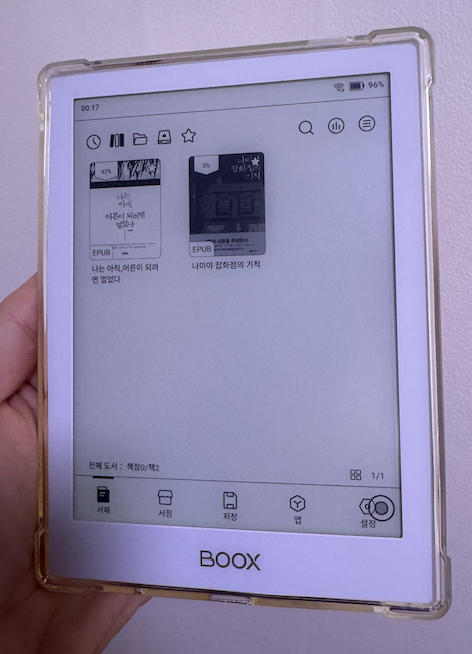
DRM이 해제되었기에 구매한 이북리더에서의 기본 리더 앱에서도 잘 열린다.

이 고생을 한 자기 합리화일지도 모르겠지만, 역시 기본 내장앱이 더 빠릿하고 쓰기 편한 것 같다ㅋㅋㅋ


DRM 기술 담당은 아니지만 콘텐츠 플랫폼 회사에서 앱 개발하는 친구.. 나중에 심심하면 거기도 도전해볼게 헿


내가 프로그래밍을 하고 좋아하는 이유는, 내가 필요로 하고 상상하던 기능이 현실이 되어 나의 삶을 보조해주기 때문인 것 같다.
그리고 나의 경험상, 내가 필요로 하는건 분명히 또 다른 누군가도 원하고 있기 마련이더라.

혼자만 쓰다가 다른 사람도 같이 쓰기 위해선 고려할게 많아지고, 불특정 다수 또한 같이 쓰기 위해선 신경 쓸게 곱절로 늘어난다.
개중엔 리버싱의 결과로 탄생하거나 그게 메인이라 공개할 수 없는 작업물도 존재하고..

그래서 세상에 공개할 순 없는 프로젝트들이지만, 혼자만 알기엔 아까운 것도 너무 많단 말이지.
나 자신의 기록 겸 이런걸 만들 수도 있다는걸 소개할 겸, 하나씩 남겨볼까 한다.

+ Recent posts